Наша научная статья принята и опубликована в материалах IEEE — одного из самых авторитетных мировых научных сообществ в области IT и искусственного интеллекта. Для нашей команды это важная веха: независимое рецензирование такого уровня подтверждает строгую математическую корректность и высокую практическую ценность нашего фреймворка TabuSDE.
Мы благодарим соавторов за глубокую проработку архитектуры. Работа над диффузионными моделями для табличных данных с обеспечением строгой дифференциальной приватности потребовала серьезных инженерных усилий, и мы рады поделиться результатами, которые уже готовы к применению в реальном бизнесе.
DOI: https://doi.org/10.1109/ICDMW69685.2025.00271
Проблема «стены приватности» в машинном обучении
Обучение нейросетей в медицине (MedTech) или финансовых технологиях (FinTech) часто упирается в жесткие регуляторные ограничения. Данные для обучения есть, но передать их разработчикам алгоритмов нельзя: врачебная тайна и политики безопасности банков запрещают любую передачу персональной информации (PII).
Раньше эту проблему пытались решать с помощью генерации синтетических данных через GAN (генеративно-состязательные сети) или VAE (вариационные автоэнкодеры). Но на практике они сталкиваются с двумя критическими ограничениями:
- Риск деанонимизации: модели склонны «запоминать» конкретные записи из обучающей выборки.
- Низкое качество на гетерогенных данных: они плохо справляются со сложными таблицами, где в одной строке смешаны числа (возраст, баланс), категории (профессия, диагноз) и множество пропущенных значений.
TabuSDE: диффузионные модели для структурированных данных
В новой работе мы представили TabuSDE — фреймворк, который успешно адаптирует технологии диффузионных моделей (аналогичных тем, что лежат в основе генерации изображений) для работы со структурированными табличными данными.
Вместо генерации картинки из шума, TabuSDE учится «распутывать» зашумленные строки таблицы, сохраняя сложные логические связи и корреляции между колонками.
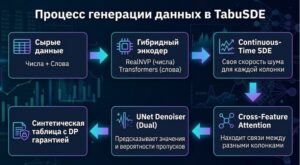
Ключевые инженерные особенности архитектуры
- Адаптивный график зашумления (Learnable Noise Schedules): Модель не зашумляет всю таблицу одинаково. Для непрерывных чисел (например, зарплата) и редких категорий задаются индивидуальные скорости зашумления.
- Гибридный энкодер: Непрерывные числа обрабатываются через слои RealNVP, а категории кодируются через Transformer-эмбеддинги, что обеспечивает максимальную точность представления данных.
- Двухголовый денойзер (Dual-headed UNet): Инновационное решение для задачи импутации (восстановления пропусков). Одна «голова» предсказывает значение в ячейке, а вторая оценивает вероятность того, что эта ячейка в реальных данных должна быть пустой.
- Гарантия дифференциальной приватности (Rényi DP): В процесс обучения встроена строгая математическая защита. Из полученных синтетических данных невозможно обратно восстановить информацию о конкретном человеке.
- Оптимизация генетическим алгоритмом (GA): Подбор гиперпараметров происходит не вслепую, а с помощью GA с динамической коррекцией пространства поиска.
Результаты тестов
Тестирование на отраслевых бенчмарках (Criteo, MIMIC-III, UCI Adult) показало значительное превосходство TabuSDE над классическими методами:
- +8 процентных пунктов к точности сохранения корреляций между колонками.
- На 12% меньше ошибок (MSE) при восстановлении пропущенных данных.
- Менее 5% потери полезности (utility loss) данных даже при включении режима полной дифференциальной приватности.
Где это применимо в реальном бизнесе?
Генерация синтетических таблиц — это не академическая задача, а готовый инструмент для решения конкретных бизнес-проблем:
- Здравоохранение и медицина (Digital Health)
Задача: Обучение диагностических ИИ без нарушения врачебной тайны.
Решение: TabuSDE генерирует миллионы «виртуальных пациентов», сохраняя реальную статистику (например, корреляцию между уровнем сахара и риском инфаркта), но без риска утечки персональных данных.
- Банки и Финтех (Anti-Fraud & Scoring)
Задача: Моделям не хватает данных о редких типах мошенничества (0.01% случаев), а клиентскими транзакциями нельзя делиться с внешней R&D-командой.
Решение: Генерация недостающих сценариев фрода (imbalance correction) с учетом всех пропущенных полей для безопасного обучения скоринговых систем.
- Интеллектуальное заполнение пропусков (Data Imputation)
Задача: Обычное удаление пустых строк («Drop NA») уничтожает до половины датасета, так как пользователи часто не заполняют профили целиком.
Решение: Модель восстанавливает пропуски с учетом сложных нелинейных зависимостей, понимая системные причины их возникновения.
- Безопасный аутсорс и хакатоны
Задача: Необходимо отдать задачу оптимизации процессов внешним подрядчикам, но нельзя показывать реальные коммерческие данные.
Решение: TabuSDE создаёт безопасный статистический клон вашего хранилища данных (DWH), сохраняя все бизнес-зависимости при полном обезличивании.
Резюме для разработчиков и Data Scientist-ов
TabuSDE доказывает, что диффузионные модели на базе SDE (Stochastic Differential Equations) с адаптивным шумом по колонкам превосходят классические GAN и VAE на табличных данных. Фреймворк обеспечивает высочайшее качество синтеза и точность восстановления пропусков, не жертвуя при этом математически доказанной приватностью пользователей.
Хотите внедрить безопасную работу с данными в вашей компании?
Если ваша команда сталкивается с нехваткой данных для обучения моделей, жесткими требованиями регуляторов к приватности или необходимостью безопасной передачи данных подрядчикам, мы готовы помочь.
Наши специалисты проведут аудит ваших задач и адаптируют фреймворк TabuSDE под специфику вашего бизнеса.
Связаться с нами для обсуждения внедрения.
По материалу.



Добавить комментарий
Комментариев пока нет