

В мире современной вычислительной технологии немногие компоненты так прочно занимают свою нишу, как Жесткие Диски (ЖД). С самого зарождения этой технологии, ЖД стали незаменимыми помощниками, надежно хранящими и предоставляющими огромные...


Основной источник: Erich Haratsch, Data Storage Innovations for Scalable AI Infrastructure, Marvell, FMS 2026, 4 августа 2026 года. Иллюстрации воспроизводят слайды доклада; источник указан под каждой.
На FMS 2026 я наткнулся на презентацию Эриха Харатша, Senior Distinguished Engineer в Marvell, с названием: Data Storage Innovations for Scalable AI Infrastructure. Доклад целиком посвящен тому, как меняется архитектура хранения данных по мере того, как AI выходит за рамки обычного обучения и превращается в огромную инфраструктуру для reasoning, агентного AI и инференса с длинным контекстом.
AI scaling is fundamentally a storage problem.
Мне кажется, это очень точная формулировка того, что сейчас происходит с инфраструктурой AI. Несколько лет мы обсуждали практически исключительно GPU. Потом выяснилось, что GPU недостаточно, нужна сеть. Затем понадобилась HBM. А теперь становится понятно, что и этого недостаточно.
Вокруг GPU возникает огромный объем данных, который нужно постоянно загружать, выгружать, сохранять, восстанавливать и передавать между уровнями инфраструктуры. В результате СХД из системы, где просто лежат обучающие датасеты, постепенно превращается в активную часть вычислительного конвейера AI.
Почему AI требует всё больше хранилища: данные, reasoning и агентный AI
Харатш начинает с довольно очевидного наблюдения: за несколько лет AI прошел путь от генеративного AI к reasoning, затем к агентному AI, physical AI и локальному AI. Но для инфраструктуры важна не столько смена названий, сколько изменение характера вычислений.
В классическом генеративном AI мы в основном имели одношаговый инференс. Reasoning означает уже многошаговый инференс. Агентный AI добавляет множество взаимодействующих агентов. Physical AI приносит модели мира. А локальный AI начинает распределять инференс между дата-центром, периферией и конечными устройствами.
Особенно важно первое изменение. Reasoning и агентный AI резко увеличивают число генерируемых токенов. Инференс перестает быть коротким запросом «промпт → ответ». Теперь это скорее «промпт → рассуждение → вызов инструмента → результат → рассуждение → еще один вызов → другая модель → финальный ответ».
Каждый такой цикл означает дополнительный контекст, дополнительный KV-кэш и дополнительное перемещение данных. Поэтому узкое место постепенно смещается. Мы все еще ограничены количеством FLOPS, но все чаще система упирается в то, насколько быстро она способна подать данные вычислителю и убрать их оттуда.
В презентации есть хороший парадокс. Если посмотреть непосредственно на размеры состояния модели и обучающего датасета, цифры огромные в человеческом масштабе, но далеко не фантастические для современной инфраструктуры хранения.
Например, Marvell приводит оценки примерно следующего порядка: GPT-3 около 1,4 ТБ состояния модели, Llama 3 405B порядка 3,2 ТБ, а для гипотетической модели фронтирного класса на 1,6 трлн параметров около 12,8 ТБ. Обучающий датасет при этом может составлять десятки петабайт.
Разумеется, часть цифр в таблице относится к оценкам, а не к официальным спецификациям моделей, и сама презентация это отмечает. Поэтому я бы смотрел на них именно как на упражнение по оценке размеров, а не как на точные характеристики конкретных LLM.
Но порядок величин действительно интересный. 12 ТБ вообще не проблема для СХД. Даже 100 ТБ не проблема. Проблема возникает, когда эти данные нужно использовать тысячам GPU одновременно. И вот тогда емкость превращается в проблему пропускной способности.
Особенно хорошо это видно на чекпоинтинге. Большие модели обучаются неделями или месяцами. Потерять несколько часов вычислений из-за отказа узла при стоимости современного кластера GPU чрезвычайно дорого. Поэтому состояние обучения регулярно сохраняется.
Marvell приводит показательный расчет: для модели порядка 1,6 трлн параметров, 30-дневного обучения и чекпоинта каждые 30 минут общий объем временных данных чекпоинтов может превысить 50 ПБ, хотя постоянный датасет в конечном счете может составлять около 200 ТБ. Предлагаемый путь данных выглядит так: GPU → NVMe → параллельная файловая система → объектное хранилище.
На мой взгляд, это один из самых важных слайдов презентации. Мы часто оцениваем СХД для AI по емкости: «Мне нужно хранить 100 ТБ модели и несколько петабайт датасета». Но СХД должна быть рассчитана совсем на другое число: сколько данных через нее пройдет за время жизни нагрузки? И оно может быть на порядки больше объема данных, который физически находится на дисках в каждый конкретный момент.
Индустрия уже сталкивается с этой проблемой на практике. PyTorch Distributed Checkpoint сохраняет части модели параллельно с нескольких ранков и поддерживает перешардирование при восстановлении на кластере другой конфигурации. В экспериментах Meta и Crusoe на 1856 GPU асинхронный чекпоинтинг сократил фоновую обработку одного чекпоинта примерно с 436 до 67 секунд. В другом эксперименте PyTorch и IBM асинхронный чекпоинтинг снизил фактический простой обучения для модели 7B примерно со 149 до 6 секунд.
То есть чекпоинтинг это уже не «резервная копия модели». Это отдельная высокопроизводительная нагрузка на СХД.
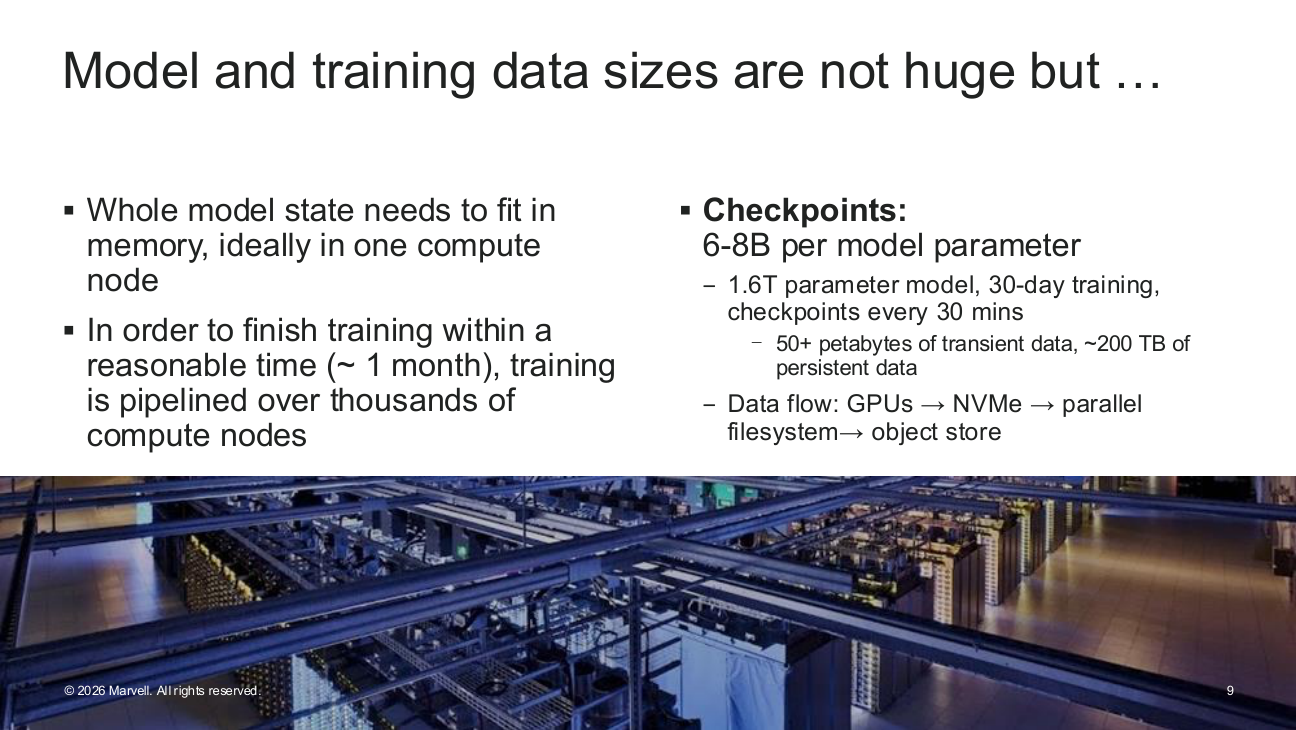
Слайд 9. Чекпоинтинг как отдельная высокопроизводительная нагрузка на СХД. Источник: Marvell, FMS 2026.
При обучении СХД в основном должна обеспечивать огромную пропускную способность. Инференс приносит совершенно другую задачу. Помимо весов модели появляется KV-кэш.
В упрощенном виде память инференса выглядит как веса модели плюс KV-кэш. Причем KV-кэш зависит от количества пользователей, глубины модели, размера скрытого слоя, длины контекста и точности.
И здесь возникает крайне неприятное свойство. Веса модели относительно статичны. А KV-кэш растет практически вместе с контекстом. Marvell приводит пример, где для одного пользователя модель с длинным контекстом может создавать десятки или даже сотни гигабайт KV-кэша.
Теперь умножим это не на одного пользователя, а на тысячи параллельных сессий. HBM перестает быть просто памятью модели. Она превращается в самый дорогой уровень кэша в мире. И становится совершенно очевидно, что хранить в HBM весь контекст всех пользователей невозможно.
Это, пожалуй, самое интересное изменение во всей архитектуре СХД для AI. Мы привыкли думать об иерархии примерно так: HBM → DRAM → SSD → HDD → лента. Каждый следующий слой медленнее, дешевле и больше.
Но инференс превращает NVMe в нечто намного более близкое к расширению памяти. KV-кэш, который не помещается в HBM GPU, можно выгрузить сначала в память хоста, затем на локальные NVMe, затем в общую СХД на NVMe.
И это уже реально работающая архитектура. Например, LMCache сегодня поддерживает выгрузку KV-кэша из GPU в RAM CPU и на локальные накопители. Более того, при нескольких NVMe можно распределять кэш по отдельным путям для разных GPU, желательно с учетом топологии PCIe и NUMA. Есть и бэкенд GDS, позволяющий работать с хранилищем через GPUDirect Storage и тем самым организовать прямой путь между памятью GPU и накопителем.
Получается очень интересная иерархия: HBM → DRAM → локальные NVMe → удаленные высокопроизводительные NVMe → емкостное хранилище. И KV-кэш начинает мигрировать между этими слоями примерно так же, как страницы памяти когда-то мигрировали между RAM и swap. Только пропускная способность теперь измеряется десятками и сотнями гигабайт в секунду.
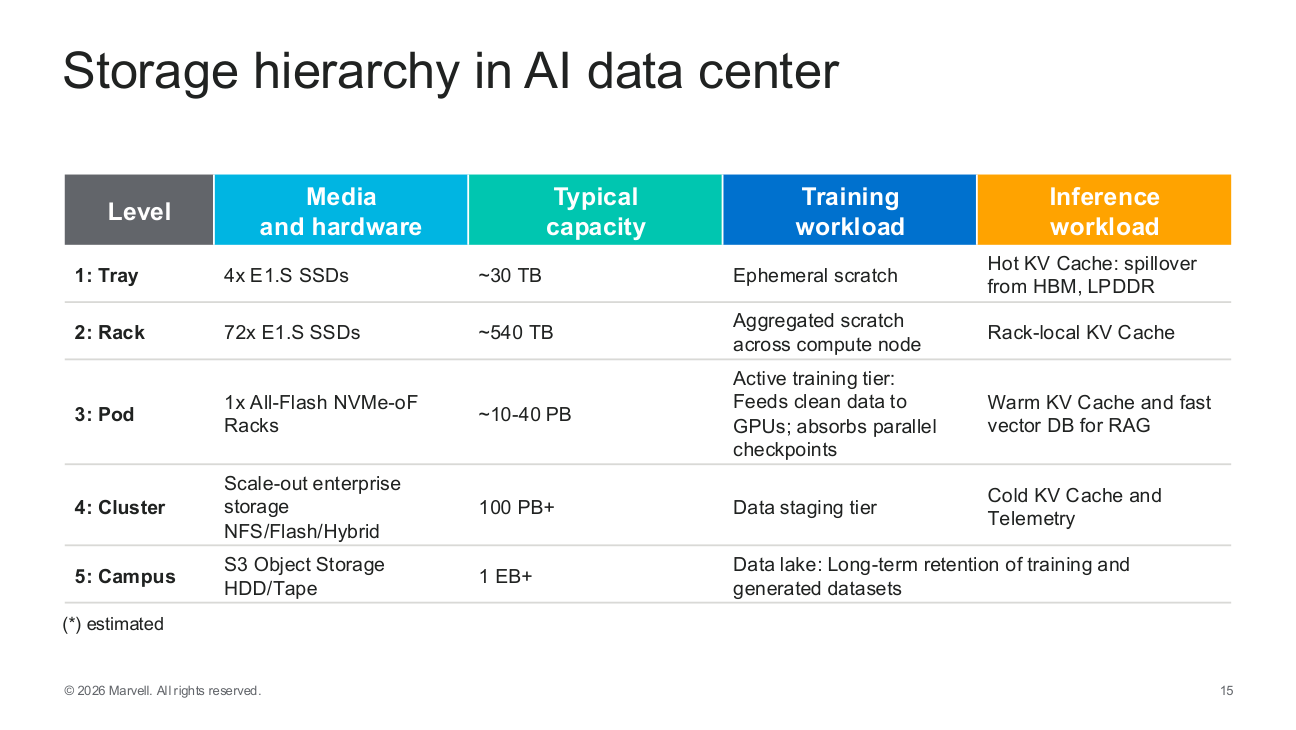
На мой взгляд, главный слайд Харатша даже не про чекпоинтинг и не про KV-кэш. Это пятиуровневая иерархия хранения ЦОД для AI. Marvell предлагает рассматривать хранение практически симметрично иерархии вычислений.
Первый уровень: Tray. Несколько локальных SSD E1.S, примерно десятки терабайт. Для обучения это временный scratch, а для инференса максимально горячий KV-кэш, уже не помещающийся в HBM или LPDDR.
Следующий уровень: Rack. Уже сотни терабайт локальных NVMe. Это агрегированный scratch для обучения и KV-кэш в пределах стойки.
Третий уровень: Pod. Здесь появляется полноценный all-flash уровень на NVMe-oF емкостью порядка 10–40 ПБ. Он должен подавать подготовленные данные GPU, принимать параллельные чекпоинты, а для инференса содержать теплый KV-кэш и быстрые векторные БД для RAG.
Четвертый уровень: Cluster. Масштабируемая корпоративная СХД на NFS, на flash или гибридных носителях. Емкость 100 ПБ и выше. Для обучения это уровень промежуточного хранения, для инференса холодный KV-кэш и телеметрия.
Наконец, пятый уровень: Campus. Объектное хранилище S3 на HDD и лентах, уже на уровне эксабайтов. Здесь находится озеро данных и долгосрочное хранение обучающих и сгенерированных датасетов.
Мне эта схема кажется крайне правильной, потому что она наконец перестает противопоставлять локальное и общее хранение. Для AI нужны оба. Причем одновременно.
ИИ разогревает рынок NAND: почему растут цены на флеш-память и SSD

Добавить комментарий
Комментариев пока нет